XDP 更早掉包不等于更省 CPU:veth +1.7% vs 虚拟驱动 virtio-net 周期约 −28%
本文地址:https://www.ebpf.top/post/xdp-vs-tc-benchmark
圈子里常说:XDP(eXpress Data Path)比 TC(traffic control)更省 CPU,因为包掉得更早。这句话听起来对,但更早只有在 skb(sk_buff)还没建起来之前做决定,才真正少干活。Donia Chaiehloudj 在 Is XDP more performant than TC?(2026-10-13)里,用同一套 UDP drop 逻辑分别挂到 TC ingress 与 native XDP(xdpdrv),在两种拓扑上各打 100 万包,把这句口号钉到数字上。原文提供的代码仓库为 doniacld/save-cpu-ebpf;截至 2026-11-02,公开访问该地址返回 404,本文未复现其中实验。
读者若在做 Linux 开发、运维或容器网络选型,下面两行相对差比绝对周期更值得带走。先用白话把两套拓扑说清楚,免得后面一出现 virtio-net 就显得突兀。
veth 是一对成对出现的软件虚拟网卡,容器和 network namespace 里最常见:一端发出去的包,对端接收时往往已经是内核的 sk_buff(skb)——收包路径上的标准元数据包。virtio-net 则是虚拟机(尤其是 KVM guest)里常见的半虚拟化网卡:驱动可以把宿主机递进来的原始帧先交给 native XDP;程序若返回 XDP_DROP,可以根本不建 skb。后文 Run1 走 veth、Run2 走 virtio-net,并不是换了两套无关实验,而是对照「skb 已经建好」与「skb 尚未建起」两条路径——同样挂 native XDP,CPU 账单会不会差一截,关键就在这里。
先给可核对的结论(禁止跨 Run 比绝对周期,只比同 Run 内 TC vs XDP):
- Run1 · veth pair,作者笔记本 AMD Ryzen 7 PRO 8840HS、kernel 6.17:cycles/pkt TC 23864 vs XDP 24263(+1.7%);instructions +2.0%;两边都建了 1e6 个 skb;协议栈
__netif_receive_skb_core计数 TC 1e6 / XDP ~100;BPF 程序自身 38 ns vs 42 ns。 - Run2 · virtio-net,拓扑为 KVM guest + host tap,周期由 Chris Tarazi 在 bare-metal 测得:cycles/pkt 8462 vs 6058(−28%);instructions −35%;max drop 1.47M → 2.06M pps(+40%);满载时 cycles/drop −40%;skb 建成数 TC 1e6 / XDP ~100;BPF 57 ns vs 54 ns。
两行对照已经足够说明:同样是 XDP,在 veth 上可能更贵一点,在 virtio-net 上才把每包周期和峰值 drop 能力一起拉开。下文先钉测量口径,再分别走读两次 Run 与 skb 时机。
1. 口号与实测:更早掉包,不等于更少干活
选型会上最容易听到的一句话是:废包尽量在 XDP 丢掉,TC 太晚、太贵。这句话把挂点早晚直接等同于 CPU 账单,听起来顺口,却跳过了一个前提——程序做决定时,内核有没有已经为这个包建好元数据。
作者开篇就把反例摆在桌上:第一套环境是 veth pair,结果 XDP 反而慢了约 1.7%。她写:
On my first setup, a veth pair, XDP came out 1.7% slower. That result is the whole point of this post.
在我的第一套环境 (一对 veth) 上,XDP 反而慢了约 1.7%。这个结果才是全文的重点。
挂上 XDP 是否一定更省,取决于决定当下 skb 是否已建。我们真正要验证的,不是 XDP 程序本身写得快不快——两边 BPF 自身都是几十纳秒量级——而是:到程序能 XDP_DROP 的那一刻,内核已经为这个包付过多少账。容器网络大量走 veth,云主机常见 virtio-net;若不分拓扑,只背一句 XDP 更早,选型很容易买错尺子。
2. 测量口径:同一 drop,两种挂点,两种拓扑
两份 eBPF 程序逻辑相同:丢弃目的端口 9999 的 UDP,其余放行;流量同为 100 万 UDP 包。差别只在挂点与网卡路径。
| 项 | 口径 |
|---|---|
| 场景 | 同一 UDP drop,端口 9999,1M 包 |
| 挂点 | TC ingress(clsact)vs native XDP xdpdrv |
| Run1 拓扑 | veth pair(原文所述仓库默认 make setup) |
| Run2 拓扑 | guest 内 virtio-net,流量经 host tap 进入 |
| 工具 | perf stat -e cycles,instructions;bpftool prog show 的 run_time_ns / run_cnt;bpftrace 计数 __netif_receive_skb_core / __alloc_skb(及释放侧) |
| 谁测 | Run1:Donia,笔记本 AMD Ryzen 7 PRO 8840HS,kernel 6.17;Run2 周期:Chris Tarazi,bare-metal |
为什么第二套改到 guest virtio-net:作者笔记本上的物理网卡不支持 native XDP,没法在驱动里、skb 建成之前挂上 xdpdrv;需要一条能在驱动内先于 skb 的挂点,于是把测量挪到 KVM guest 的 virtio-net(流量经 host tap 进入)。
四类工具分工可以记成一句话:perf 回答贵不贵,bpftool 回答 BPF 自身占多少,bpftrace 回答有没有出栈、有没有建 skb。缺了任何一类,都容易把出栈成功误读成已经省了 CPU。
挂点示意(命令只说明钩子,不构成完整复现步骤):
|
|
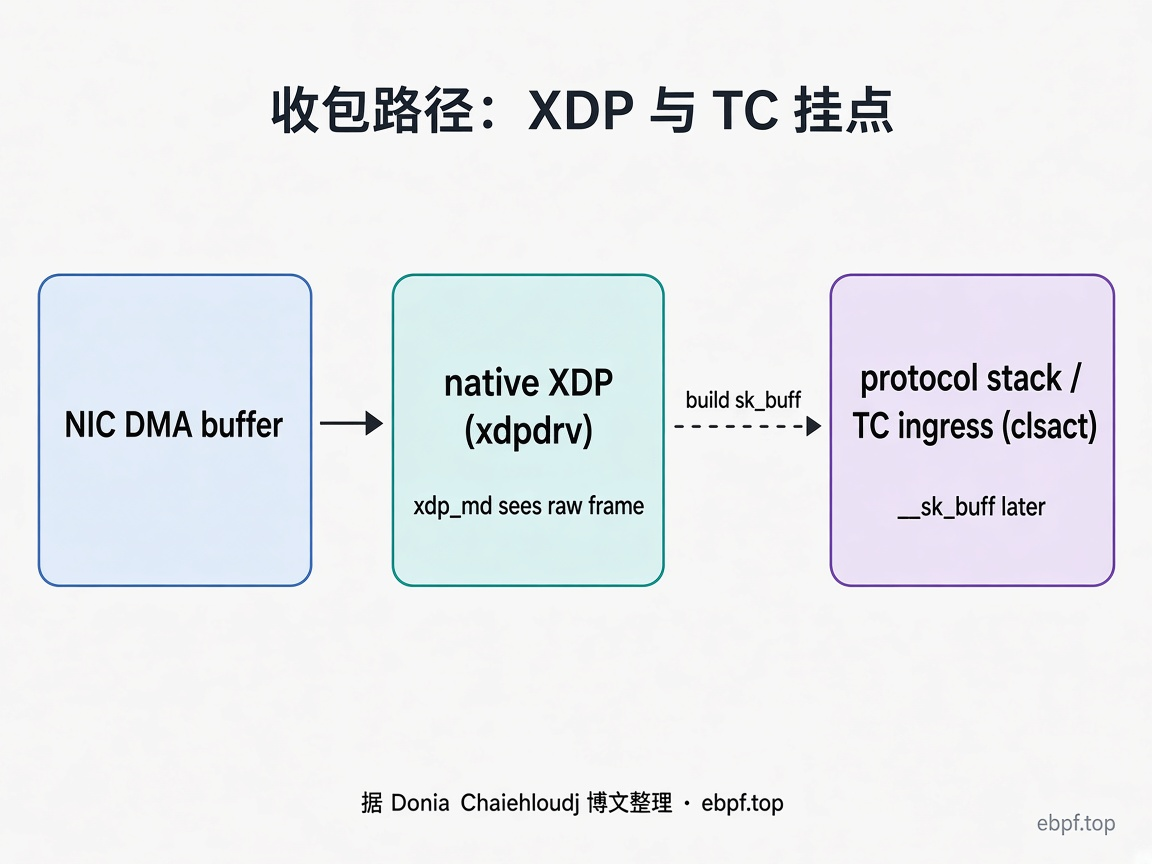
图1 挂点:native XDP 在驱动侧看原始帧;TC ingress 更晚,此时内核通常已建好 sk_buff(据 Donia Chaiehloudj 博文 Diagram 1 整理)
native XDP 按设计应在驱动里、对 DMA 进来的原始帧运行,上下文是 xdp_md;决定 XDP_DROP 后回收缓冲,不必为每个废包建 skb。按 iproute2 的 ip-link 手册,默认使用 ip link set dev … xdp … 时,驱动不支持 native XDP 才会回退到 generic XDP;本文示例使用的 xdpdrv 强制 native 模式,不支持时会报错,不会自动回退。generic XDP 运行时 skb 已建,不能省掉这部分分配成本。TC 侧则经由 clsact 挂在 ingress,程序看到的是 __sk_buff,到达时 skb 元数据通常已就绪。
出栈半边用 bpftrace 盯 __netif_receive_skb_core:TC 下约 100 万 次;XDP 下约 ~100 次。包照样被收、被丢,变的是协议栈还要不要为它们走完整接收路径。
这里有个容易误读的地方:出栈次数掉下去,看起来已经赢了。Run1 会告诉我们——出栈只是半边故事,另一半是 skb 有没有建成、perf 看到的每包周期有没有跟着降。测量清单里把四类工具并列,就是为了防止只看一个计数器就下结论。
3. Run1 · veth:出栈了,周期却贵约 1.7%
Run1 按原文所述的仓库配置:veth pair,从 netns 打 1M 包。这是容器节点上最常见的软件网卡形态之一,也是许多人默认挂 XDP 的地方。作者笔记本测得:
| 指标 | TC | XDP |
|---|---|---|
| stack skbs processed | 1,000,000 | ~100 |
| skbs built and freed | 1,000,000 | 1,000,000 |
| cycles / packet | 23,864 | 24,263(+1.7%) |
| instructions / packet | 27,323 | 27,862(+2.0%) |
| BPF program time | 38 ns | 42 ns |
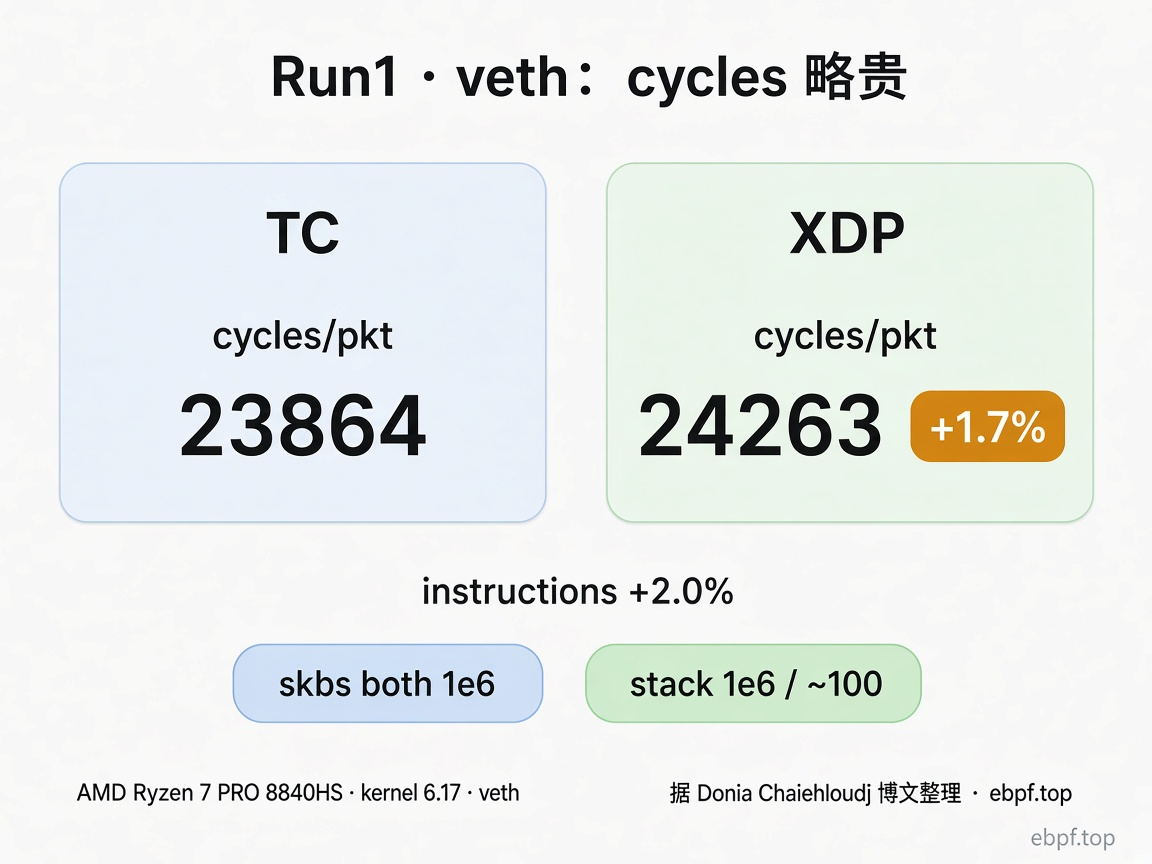
图2 Run1 对照:出栈成功,但两边都建了 1e6 个 skb;cycles/pkt 23864→24263(据原文表誊写)
每一行对应什么工具,作者写得很清楚:
- stack skbs processed:
kprobe:__netif_receive_skb_core - skbs built and freed:
kprobe:__alloc_skb与kprobe:kfree_skbmem - cycles / instructions:
perf stat - BPF program time:开启 BPF 统计后,
bpftool prog show的run_time_ns / run_cnt
XDP 把约一百万包挡在协议栈外,CPU 却略贵。真正露馅的是skbs built and freed:两边都是 1,000,000。出栈 ≠ 省掉分配。
4. 机制:veth 在 XDP 之前已经建好 skb
veth 是软件设备。对端一发送,包已经是 sk_buff;接收路径用 veth_convert_skb_to_xdp_buff 把现成 skb 转成 XDP 能看的缓冲,再进 XDP。分配发生在 XDP 之前;XDP 跳过了后面的栈处理,却跳不过这次分配,转换本身还多一点点活。作者的原话很干脆:
“Out of the stack” is not the same as “no work done.”
出栈,并不等于没干活。
可以把它想成:你在家门口拦访客,本意是少开一次客厅灯;但如果门卫亭已经给每位访客办好了胸卡,再在门口说一声拒绝,胸卡工本费照样发生。veth 上的 XDP 更像后一种——拦下了进客厅(协议栈)的人,却没省掉办胸卡(分配 skb)的活,还多走了一次把胸卡格式转成 XDP 能读的手续。
图3 veth 路径:XDP 跑在 skb 已存在之后(谁在用:容器 / netns 成对软件口;据 Donia Chaiehloudj 博文 Diagram 2 整理)
对比 virtio-net:native XDP 在驱动里先碰原始帧,决定 drop 则根本不建 skb——这才是更早有意义的拓扑。
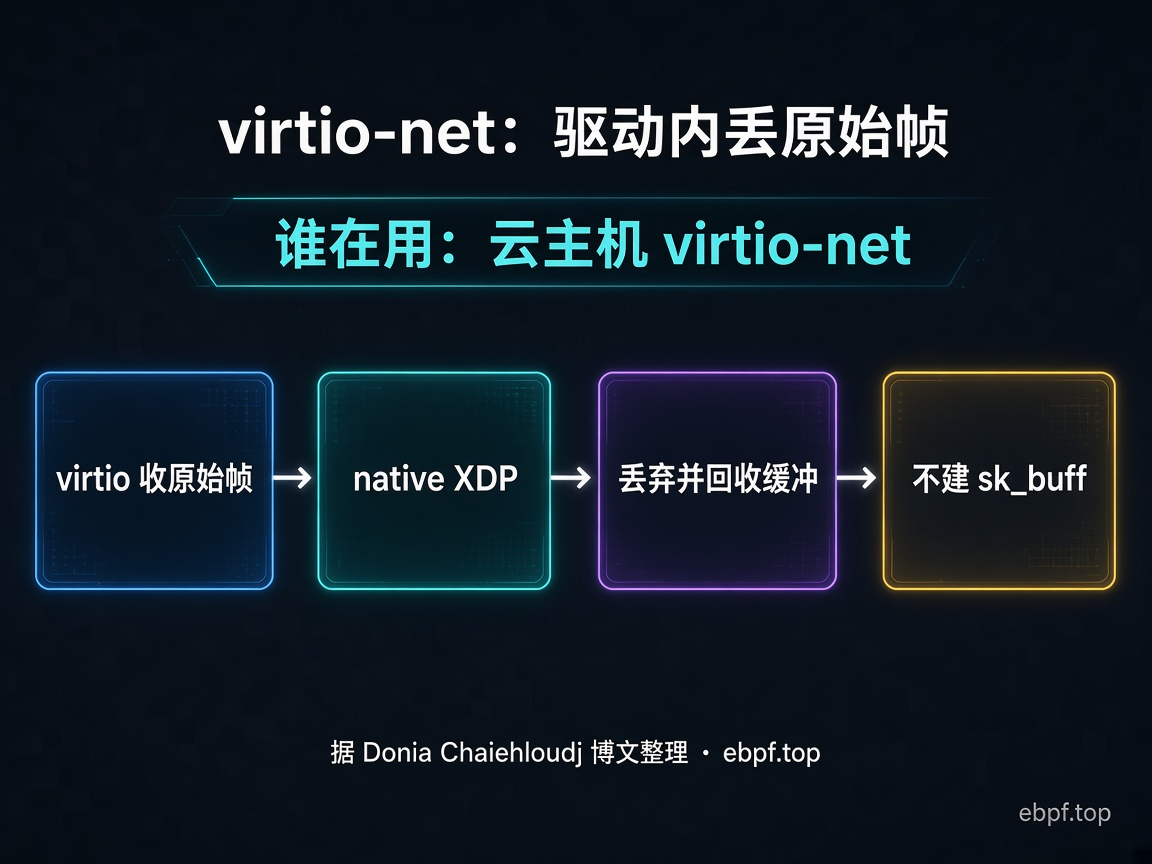
图4 virtio-net 路径:XDP_DROP 发生在 skb 分配之前(谁在用:KVM/云主机 guest 半虚拟网卡;据 Donia Chaiehloudj 博文 Diagram 3 整理)
这一点不是作者个人环境的怪癖。Cilium 的 XDP 文档对虚拟设备有同类说明:像 veth 这类路径内核本来就在 skb 上工作,XDP 无法在分配之前介入;generic 模式还有 cloned skb、线性化等限制。对已经建立在 skb 上的路径,tc BPF 往往更合身,因为它从一开始就围绕 __sk_buff。
5. Run2 · virtio-net:周期约 −28%,峰值 drop 约 +40%
再提醒一句:virtio-net 是 KVM guest 里常见的半虚拟化网卡;和 veth「对端一发、本端往往已是 skb」不同,native XDP 可以在驱动里先碰原始帧,XDP_DROP 时不必建 skb。作者因笔记本物理网卡不支持 native XDP,才把第二套挂到 guest virtio-net(流量经 host tap);周期与指令由 Chris Tarazi 在 bare-metal 上测——需要真实硬件 PMU(Performance Monitoring Unit)。同口径数字如下:
| 指标 | TC | XDP |
|---|---|---|
| skbs built | 1,000,000 | ~100 |
| cycles / packet | 8,462 | 6,058(−28%) |
| instructions / packet | 6,327 | 4,099(−35%) |
| max drop rate | 1.47M pps | 2.06M pps(+40%) |
| cycles / drop at max rate | 2,870 | 1,710(−40%) |
| BPF program time | 57 ns | 54 ns |
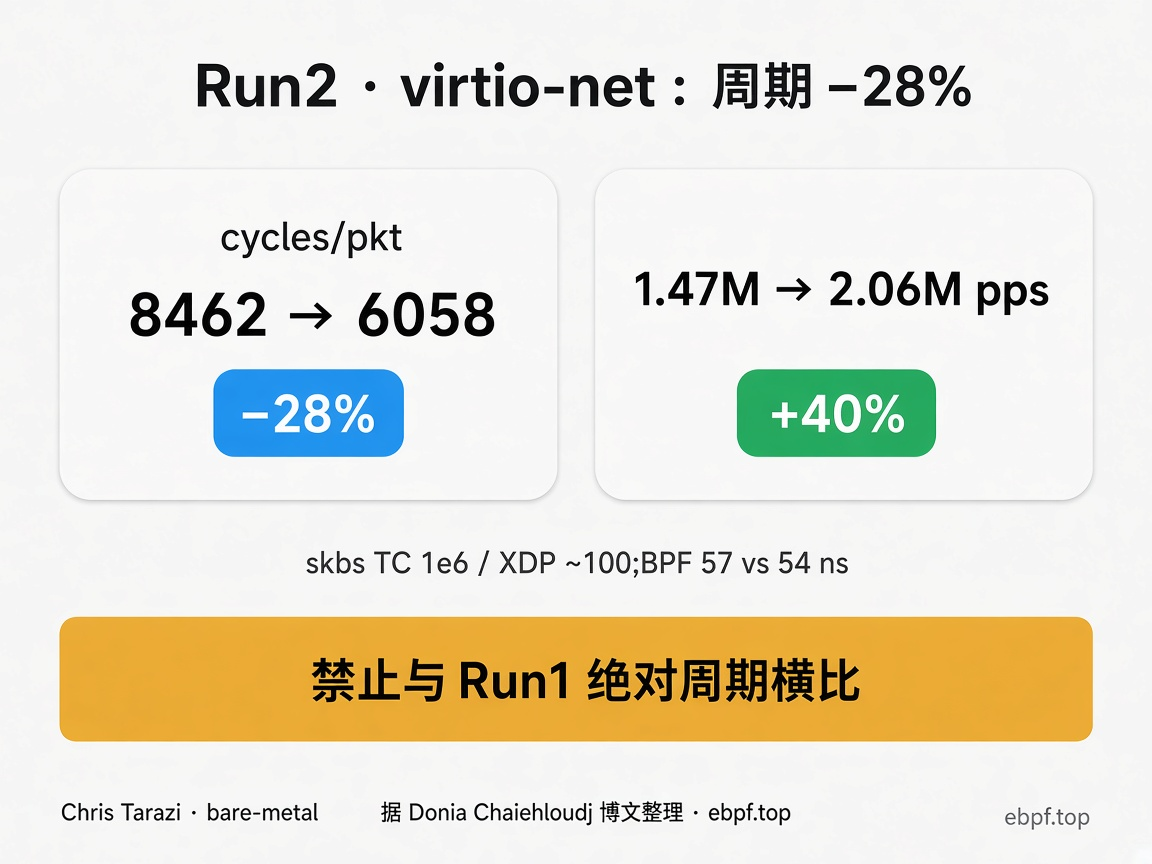
图5 Run2 对照:skb 建成数从 1e6 降到 ~100;BPF 自身仍是几十纳秒级(据原文表誊写)
这次省下来的,几乎全是内核收包路径上没做的工:不必 napi_alloc_skb / napi_build_skb,也不必走到 __netif_receive_skb_core 再 cls_bpf_classify。火焰图里,TC 一侧能看到建 skb、走接收核、最后才分类丢弃的整座塔;XDP 一侧是 virtnet_poll → receive_buf → virtnet_xdp_handler → 程序 drop,塔消失的宽度对应表里那约 28% 的周期。可交互的 flame graph 见 Donia Chaiehloudj 的原文。
也就是说:同为 drop,TC 是先建好元数据再丢掉,XDP 在 virtio-net 上是决定不建。CPU 账单跟着变的是后者。
怎么读这些数: 只在同一 Run 内比 TC 与 XDP。Run1 钉在发送侧 pinned CPU、裸机笔记本;Run2 在 guest 收包 vCPU 上,VM 开销会抬高绝对周期。跨 Run 比 23864 和 8462 没有意义;有意义的是各自内部的 +1.7% 与 −28%。
BPF 程序自身 57 ns vs 54 ns,几乎一样——差的不是 BPF 程序执行的那几十纳秒,而是驱动是否在分配 skb 之前就做完了决定。
再强调一次读表纪律:Run1 的 2.4 万 cycles/pkt 与 Run2 的 6–8 千 cycles/pkt 不能横比。前者钉在发送侧 pinned CPU、裸机笔记本;后者在 guest 收包 vCPU 上,虚拟化本身就会抬高绝对开销。信号是各自内部的相对差:veth 上约 +1.7%,virtio-net 上约 −28% 与峰值 drop 约 +40%。
6. 云 VM:没有硬件 PMU,还能看见半边故事
perf 的 cycles 来自 PMU。裸机或暴露了虚拟 PMU 的 KVM guest 能读到真数;常见公有云 VM、以及作者用的 Lima 虚拟机(宿主机为 Mac)往往把 PMU 藏起来,perf stat -e cycles 会变成空白。
| 环境 | 硬件 cycles? |
|---|---|
| Bare-metal Linux | 有 |
| 带虚拟 PMU 的 KVM guest | 有 |
| 公有云标准实例 | 通常无 |
| Apple Silicon 上的 Virtualization.framework,如 Lima、UTM | 无 |
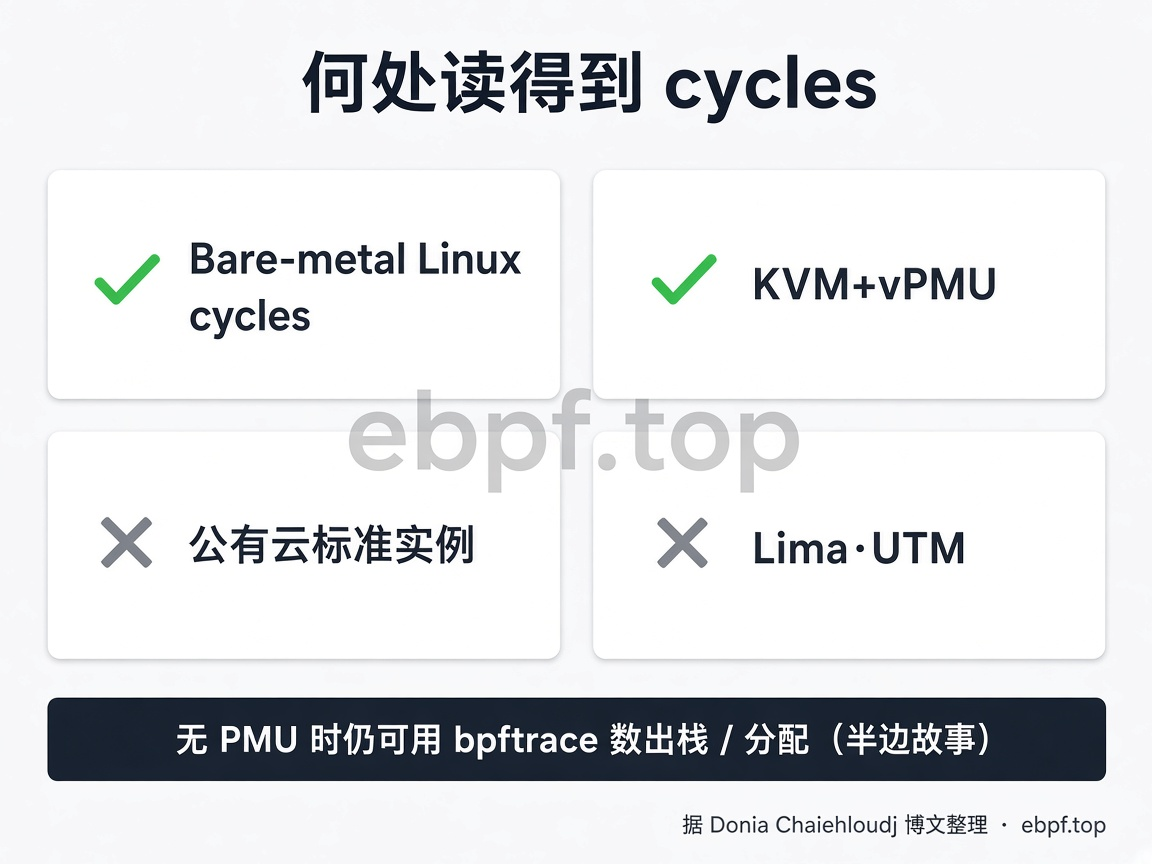
图6 测量边界:无 PMU 时仍可用 kprobe 复现出栈半边(据原文环境表整理)
读不到 cycles,不等于实验废了。__netif_receive_skb_core 计数只靠 kprobe,不依赖 PMU,云上也能跑,照样能看见 XDP 是否把百万包挡在栈外;再配上 __alloc_skb 一类计数,还能核对 skb 到底有没有建成。作者因此把周期数字放在 bare-metal,把skb/出栈计数留给任何机器——包括你自己的笔记本虚拟机——去复现。
这对排障很实用:你在云上复现出栈、在有 PMU 的机器上补周期,两半拼起来,仍然能回答这次 XDP 有没有少干活,而不必因为 perf 空白就放弃对照。
生产里同一机制并不陌生:Cilium 等在节点物理口挂 XDP,在驱动里做转发或丢弃,让只经过本节点的流量少付一次完整收包账。百分比来自这篇 UDP drop 微基准,不是 Cilium 官方数字;能带走的是机制,不是把 −28% / +40% 直接贴到集群报表上。云上的 Kubernetes 节点本身常常就是一台 VM:你能享用 native XDP 的早决策,却往往同样读不到硬件 cycles——这也解释了为什么作者要借 bare-metal 把周期测出来,再把可移植的出栈计数留给大家在云上复现。
7. 选型:容器 veth、virtio 与往后看
把两张表叠在选型问题上,比背口号管用:
- 容器常用 veth(或同类 skb 路径):XDP 可能出栈了,但 skb 已建;本文 Run1 甚至略贵约 1.7%。策略、分类、conntrack 一类逻辑本来就围绕 skb 时,TC ingress 往往更贴路径——上下文天然是
__sk_buff,也不必先付一次转换成本。若目标是容器网络少排队、吞吐和延迟追平主机,方向也可能是 netkit 等设备模型,而不是在 veth 上强行押注 native XDP 的周期收益。 - virtio-net / 真正的驱动态 native XDP:drop 或转发发生在 skb 之前,Run2 给出同口径下约 −28% 周期与约 +40% 峰值 drop。节点边缘卸流量、丢废包、做早期负载均衡,这才是口号成立的地形。换驱动前先确认:目标网卡是否支持
xdpdrv;若不支持,强制 native 挂载会失败,需另行选择 generic 模式并重新评估收益。 - 观测怎么选尺子:能借 PMU 就看 cycles/instructions,并用
bpftool看清 BPF 自身是否只占几十纳秒;云上空白就退回 skb 建成数与__netif_receive_skb_core计数——半边故事仍足以否定挂了 XDP 就省了的假设。跨机器对比时,只搬相对差(同 Run 内 TC vs XDP),不搬绝对周期。
往后看,方法可以复用:先钉死挂点与拓扑,再决定信哪一列数字。有可用 PMU 时可测周期,云 VM 多半只能观测出栈/skb 半边。本文未在本地复测,数字一律按原文誊写。原文提供的 save-cpu-ebpf 仓库截至 2026-11-02 公开访问返回 404,因此无法核验当前 Makefile,也不能保证 make all 可运行;404 本身不代表仓库已删除。复现前需先取得可访问的代码,并核对环境与测量步骤。
8. 总结:最省的包,是决定不去建的那一个
两套程序丢的是同一类包。省下的 CPU,是内核没做的收包路径;而内核只有在驱动于分配 sk_buff 之前跑 XDP 时,才会整段跳过。veth 上 skb 已在,XDP 出栈却省不了工;virtio-net 上先 drop 原始帧,约 28% 的每包周期可以一起拿走。
作者收束句值得原样记下:
The cheapest packet to process is the one you decide not to build. XDP does not make the work faster; it removes the work entirely, as long as you run it in the right place.
处理起来最便宜的包,是你决定不去建的那一个。XDP 并不是把活干得更快,而是在你挂对位置时,把活整段拿掉。
相信读完之后,再听到 XDP 一定比 TC 省时,你会先问三件事:挂在哪张网卡、skb 那时建了没有、cycles 是同一次 Run 内比的吗? 能把这三问变成习惯,也就不容易再被一句更早掉包带进沟里。这也就是本文的价值所在。
原文提供的代码与 Makefile 地址为 doniacld/save-cpu-ebpf(当前公开访问返回 404,见上文复现说明),本文实验数据来自 Donia Chaiehloudj 的原文;周期侧感谢 Chris Tarazi 在 bare-metal 上的复测。本人水平有限,如有错误欢迎批评指正。
延伸阅读
若还想顺着读,可看这几篇:
- 原文作者:DavidDi
- 原文链接:https://www.ebpf.top/post/xdp-vs-tc-benchmark/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。
- 最后更新时间:2026-11-02 16:02:58.25152365 +0000 UTC